Как посчитать, сколько раз ролик или джингл вышел в эфир
Клиент заказал девять выходов с шести до десяти утра. Лог автоматизации говорит, что девять ушли. Клиент просит подтверждение. Кому-то придётся открыть запись эфира и считать — а запись четырёхчасовая, ролик двадцатисекундный, и два выхода срезали новостями.
Считать выходы на слух долго и ненадёжно. Считать по логу автоматизации быстро, но это ничего не доказывает: в логе то, что было запланировано, а не то, что ушло с передатчика. В этой статье — третий путь: искать каждый ролик в самой записи и дать программе посчитать.
Таблица выходов
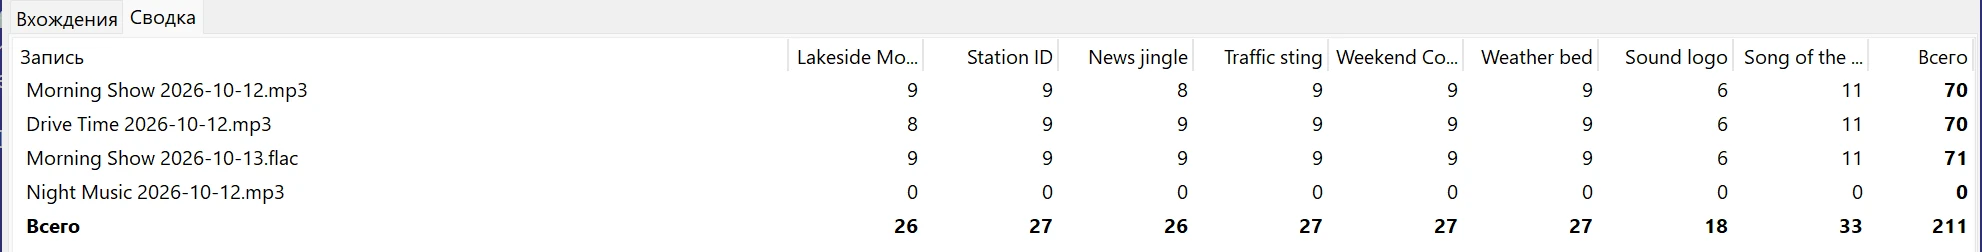
Вкладка «Сводка»: строки — записи, столбцы — ролики, в ячейках число выходов. Итоги отвечают на вопрос за весь день.
За каждой ячейкой стоит список. Переключитесь на «Вхождения» и сгруппируйте по фрагментам: под каждым роликом — все его выходы с началом и концом в записи, сходством в процентах и отметкой, полный выход или частичный. Этот список вы проверяете на слух, выгружаете и отправляете.
По шагам
- Соберите ролики. Лучшие фрагменты — файлы, которые вы отдали в автоматизацию: ролик целиком, чистый, в любом формате. Нажмите «Добавить фрагменты…» или перетащите их все в левый список. Дайте фрагментам понятные имена: они попадут в таблицу и в отчёты. Сохраните их как набор (Файл → Сохранить фрагменты как набор…), и в следующем месяце весь набор добавится одним щелчком.
- Добавьте записи. «Добавить записи из папки…» берёт папку логгера за день со всеми часовыми файлами. MP3 64 или 128 кбит/с, WMA, Opus, FLAC или WAV, часовые файлы или один суточный — всё равно: сравнивается звук.
- Нажмите «Найти». Каждая запись декодируется один раз, все ролики проверяются вместе, на всех ядрах процессора. Находки появляются по ходу поиска.
- Прочитайте «Сводку». Каждый ролик в каждом часе, итоги по роликам и по записям. Сверьте столбец с заказом: девять заказано, девять найдено — готово. Найдено восемь — следующий шаг покажет, какого не хватает.
- Проверьте сомнительные выходы. На вкладке «Вхождения» отсортируйте по сходству. Выходы на 80–100 % чистые. Выход с пометкой «частично 0.0–12.4 с» у 20-секундного ролика срезали на двенадцатой секунде: послушайте (щелчок, затем «Слушать») и решите, считать ли. Отметьте находку как ложную — она уйдёт из счёта и из выгрузки; подтвердите — будет видно, что вы её проверили.
- Выгрузите. Файл → Экспорт результатов в CSV… даёт по строке на выход: запись, ролик, начало, конец, длительность, сходство, прозвучавшая часть ролика и уровень. Сохранить HTML-отчёт… даёт готовую страницу с таблицей выходов и всеми выходами под каждой записью. (И то и другое — с лицензией; подсчёт и проверка бесплатны.)
Что считать выходом
Станция и клиент могут понимать это по-разному, поэтому программа оставляет решение вам и даёт инструменты:
- Полный или частичный. Выход полный, когда прозвучал весь ролик, и частичный, когда только часть; часть показана в секундах ролика. Фильтр «Показать» над списком переключает все, только полные и только частичные, «Сводка» следует за фильтром.
- Сходство. Ролик под ведущим или после жёсткой обработки всё равно совпадает, но с меньшим процентом. Поле «Сходство от» задаёт нижнюю границу; числа обновляются сразу.
- Чувствительность. «Строго», «Обычно» и «Чувствительно» задают, насколько далеко от оригинала может быть совпадение. Переключение перефильтровывает готовые результаты без нового поиска. Ниже текущего порога находки не считаются, но остаются видны серым как «возможные» (Вид → Показывать возможные находки), так что недостача никогда не бывает загадкой.
- Одно место — один выход. Две версии ролика с одной подложкой или три ролика одного рекламодателя с одинаковым хвостом могут совпасть с одними и теми же 20 секундами. Настройки → На одном месте только лучший фрагмент оставляет лучшее совпадение и убирает остальные, чтобы один выход не посчитался трижды.
От числа — ко времени
Число говорит, что ролик вышел девять раз. Клиент обычно хочет знать ещё и когда. Логгеры эфира называют файлы по часу начала — 2026-10-20_06-00.mp3 и подобное, — и Audio Scanner берёт время начала из имени, так что у каждого выхода рядом со смещением в файле появляется реальное время по часам. HTML-отчёт тогда читается как эфирная справка: ролик, дата и время, длительность, сходство. Как это настроить и как запускать каждый день из командной строки — в статье «Эфирная справка по записи эфира: подтверждение выхода рекламы своими силами».
Не только реклама
Тот же подсчёт работает для всего, что повторяется в длинной записи:
- Оформление эфира: сколько раз на самом деле прошли каждая отбивка, джингл и часовая заставка.
- Сетевые и синдицированные программы: вышли ли у партнёра сетевые ролики и заставка передачи.
- Подкасты: в скольких выпусках есть старая заставка, спонсорская подложка или концовка, которую пора заменить.
- Записи звонков: в скольких звонках прозвучало обязательное уведомление или музыка ожидания; для звука 8 кГц включите «Телефонную полосу».
- Мониторинг музыки: сколько раз трек или сэмпл встречается в миксе или в суточной программе.
Повторный поиск быстрый: отпечатки просканированных записей запоминаются, и новый ролик проверяется по всему архиву без повторного декодирования.
Впервые в программе? Начните с статьи о том, как найти, где в длинной записи звучит нужный фрагмент.
Посчитайте выходы по своим записям
Бесплатная версия: поиск, подсчёт, прослушивание и проекты без ограничения по времени. Лицензия добавляет CSV, HTML-отчёт и командную строку.
Скачать бесплатно Купить — 2990 ₽✅ Бесплатная версия находит и проигрывает всё | ✅ Полностью офлайн | ✅ Windows 10, 11