 Audio Scanner
Найдите любой фрагмент звука в многочасовых записях — ничего не загружая в облако
Audio Scanner отвечает на один вопрос: где именно в этой длинной записи звучит вот этот звук? Дайте ему короткие фрагменты — джингл, рекламный ролик, кусок музыки, любой звук — и длинные записи. Он покажет каждое вхождение с точным таймкодом и посчитает, сколько раз прозвучал каждый фрагмент. Как поиск по тексту, только для звука.
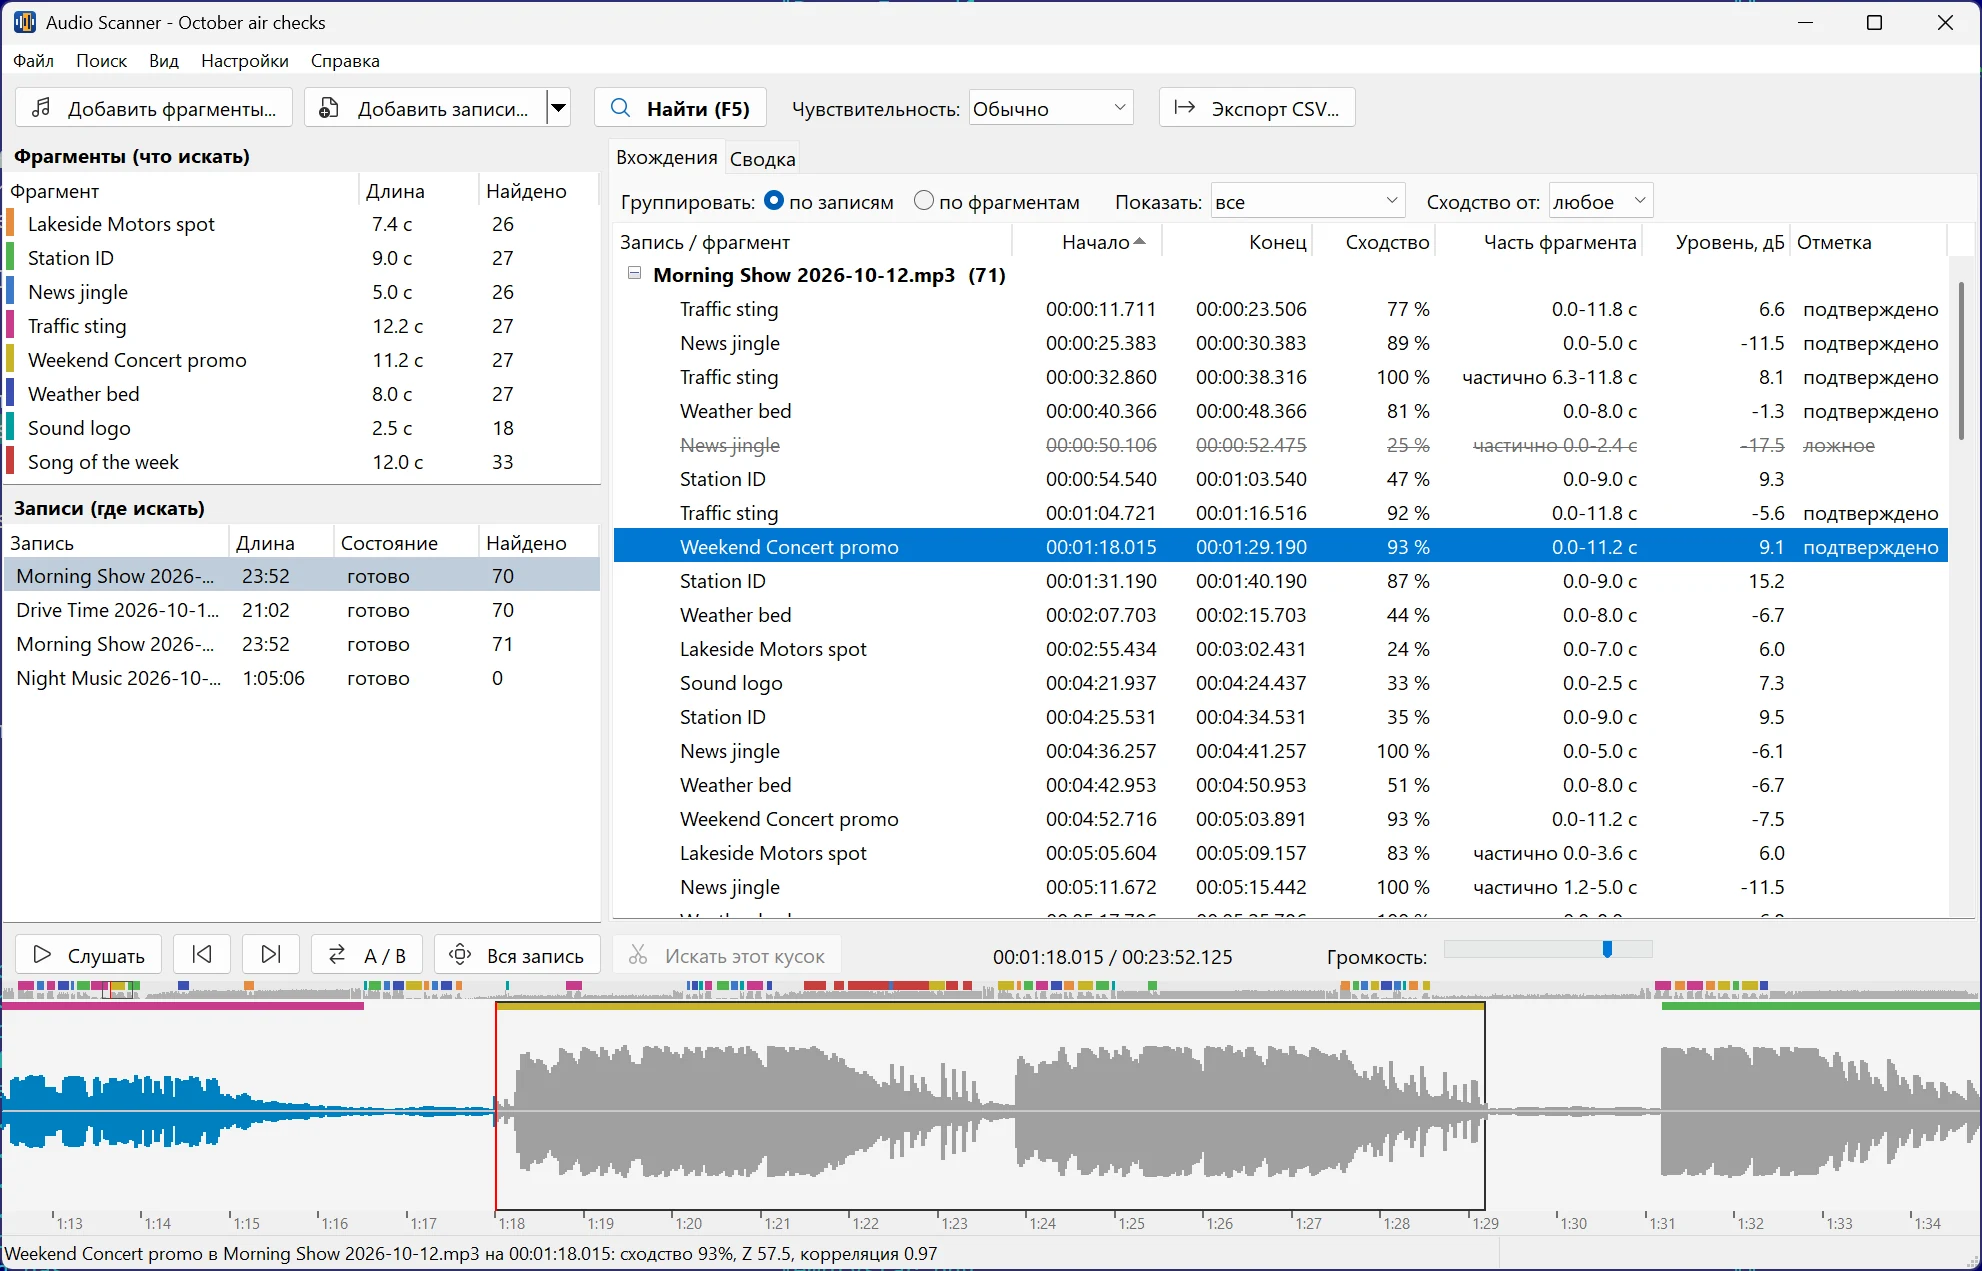
Восемь роликов станции в двух с половиной часах эфира: каждый выход со временем, сходством и волной
Что умеет
- Много фрагментов и много записей за один проход — добавьте ролики и целую папку записей, нажмите «Найти»
- Точное место каждого выхода: начало и конец до миллисекунды, сходство в процентах, уровень сигнала
- Находит фрагмент, даже если он тише или громче, обрезан, звучит под голосом диктора или под музыкой, — и показывает, какая часть фрагмента прозвучала
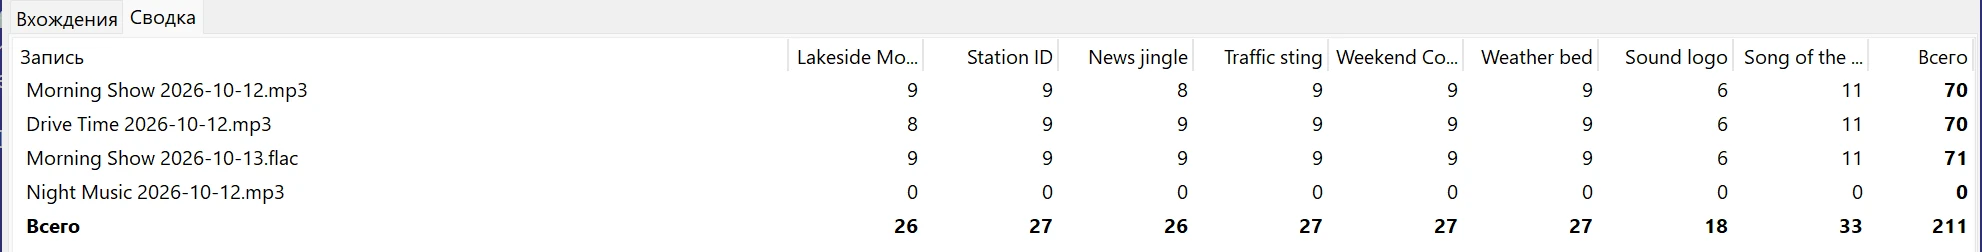
- Число выходов каждого фрагмента в каждой записи — в сводной таблице с итогами
- Реальное время выхода каждого ролика — начало записи берётся из имени файла логгера (2026-10-20_14-00.mp3 и подобных), из даты файла или задаётся вручную
- Эфирная справка — готовый HTML-отчёт для клиента: что искали и где, таблица выходов, каждый выход со временем
- Проверка на слух: волна с отметками всех находок, прослушивание с любого вхождения, переключение A/B между исходным фрагментом и найденным
- Отметки «подтверждено» и «ложное», фильтр по сходству, экспорт в CSV
- Чувствительность меняется на лету без повторного поиска; находки ниже порога остаются видны как «возможные» — ответ «не найдено» никогда не бывает наугад
- Метки для монтажа — метки Audacity, CUE-лист и маркеры Adobe Audition по всем находкам в записи, или сохранение находки в WAV
- Повторный поиск за секунды — отпечатки просканированных записей запоминаются, и новый ролик проверяется по всему архиву без повторного декодирования
- Командная строка для планировщика: ежедневная эфирная справка без открытия окна
- Любые форматы и битрейты — MP3, WAV, FLAC, AAC/M4A, OGG, Opus, WMA, APE и другие: сравнение по звучанию, а не по байтам
- Режим телефонной полосы для записей звонков (8 кГц, узкая полоса)
Число выходов — одним взглядом
Вкладка «Сводка» считает, сколько раз каждый ролик прозвучал в каждой записи. Вышла ли реклама клиента девять раз за утро, как в эфирной сетке? Ответ виден сразу.
Быстро даже на очень длинных записях
Audio Scanner читает запись один раз и ищет все фрагменты одновременно, на всех ядрах процессора. Суточная запись MP3 и 50 роликов — примерно минута на обычном 4-ядерном ПК. Памяти нужно меньше 200 МБ, и её расход не растёт с длиной записи — сутки эфира или WAV-файл на 4 ГБ не проблема. Однажды просканированные записи запоминаются: следующий поиск по тому же архиву с новыми роликами обходится без декодирования и занимает секунды.
🔒 Конфиденциально — ничего не покидает ваш компьютер
Онлайн-сервисы распознавания звука требуют загрузить записи на чужой сервер. Для многочасовых файлов это долго, а часто и просто нельзя: реклама до выхода в эфир, доказательства по делу, невышедшие программы, конфиденциальные звонки и интервью.
Audio Scanner обрабатывает всё локально, на вашем компьютере. Без аккаунта, без подписки, интернет для поиска не нужен. Ваши записи не попадают в облако.
Единственное исключение — по вашему решению: если ролик пропущен или найден неверно, этот случай можно отправить нам, чтобы улучшить поиск. В окне перечислено, что именно уйдёт — фрагмент и 30-секундный кусок записи вокруг места, — и ничего не отправляется без вашего согласия.
Кому пригодится
- 📻 Радиостанциям и рекламодателям — убедиться, что каждый оплаченный ролик вышел в эфир: число выходов и таймкоды по собственной записи эфира
- 🎙️ Подкастерам и монтажёрам — найти заставки, рекламные вставки и повторяющиеся куски во всех выпусках, чтобы вырезать или заменить
- 📞 Колл-центрам и банкам — проверить, что обязательные объявления и предупреждения действительно звучали в записях звонков, не передавая звонки наружу
- ⚖️ Юристам и комплаенсу — найти нужный фрагмент в записях-доказательствах, не отдавая конфиденциальный звук третьим лицам
- 🗄️ Архивистам и исследователям — искать известный отрывок в больших звуковых архивах
- 🎧 Музыкантам и правообладателям — проверить, где в длинных записях звучит ваш сэмпл, трек или звук
Как это работает
- Добавьте фрагменты — то, что ищете. Перетащите файлы в окно или выберите их; набор фрагментов можно сохранить и использовать снова.
- Добавьте записи — где искать: файлы или целые папки с подпапками.
- Нажмите «Найти». Audio Scanner сравнивает акустические отпечатки — технология того же класса, что в нашем Audio Comparer, — и показывает находки по мере поиска.
- Проверьте и выгрузите. Щёлкните находку — она откроется на волне, её можно послушать, подтвердить или отметить как ложную; затем сохраните HTML-отчёт, выгрузите список в CSV или метки для монтажа. Всё сохраняется в проект, к нему можно вернуться позже.
Пошаговые статьи: как найти, где в длинной записи звучит нужный фрагмент, как посчитать выходы ролика или джингла по записи эфира, как сделать эфирную справку по записи эфира.
Бесплатная версия и лицензия
Скачайте Audio Scanner бесплатно: он находит, показывает и проигрывает все вхождения без ограничения по времени. Лицензия (2990 ₽, один раз) открывает HTML-отчёт, экспорт в CSV и метки для монтажа, копирование результатов и командную строку и убирает окно-напоминание. Без подписки.
Частые вопросы
Как найти, в каком месте длинной записи звучит нужный фрагмент?
Добавьте фрагмент и запись и нажмите «Найти». Audio Scanner сравнит акустические отпечатки и покажет каждое вхождение с началом и концом — даже если фрагмент звучит тише, частично обрезан или поверх него говорит ведущий.
Записи загружаются в облако?
Нет. Всё работает на вашем компьютере. Записи никуда не уходят — загружать нечего, сервера нет.
Можно ли посчитать, сколько раз джингл или реклама вышли в эфир?
Да, это основная задача. Добавьте ролики и записи эфира: на вкладке «Сводка» — число выходов каждого ролика в каждой записи, в списке — точное время каждого выхода.
А если фрагмент обрезан или поверх него говорят?
Он всё равно найдётся. Неполный выход помечается как «частично» вместе с прозвучавшей частью фрагмента, например «частично 2.1–7.0 с». Процент сходства показывает, насколько находка близка к оригиналу.
Можно ли получить реальное время выхода, а не смещение от начала файла?
Да. Audio Scanner берёт начало записи из имени файла — так называют файлы логгеры эфира, например 2026-10-20_14-00.mp3, — или из даты файла, или вы задаёте его вручную. После этого у каждого выхода есть время по часам: в списке, в CSV и в отчёте.
А если ролик пропущен?
Переключите чувствительность на «Чувствительно» — результаты обновятся сразу, без нового поиска, а находки ниже текущего порога покажутся серым как «возможные». Если ролика всё равно нет, щёлкните место на волне и выберите «Сообщить о пропуске»: с вашего согласия фрагмент и короткий кусок записи уйдут нам, и мы подстроим поиск.
Можно ли запускать поиск автоматически каждый день?
Да. В лицензионной версии есть командная строка: AudioScanner.exe /scan /needles "D:\ads\*.mp3" /in "D:\air\2026-10-20" /html "D:\reports\20.html" ищет без открытия окна и пишет отчёт, так что планировщик может готовить эфирную справку за каждый день.
Какой длины могут быть записи?
Любой. Суточная запись и 50 роликов — около минуты на 4-ядерном ПК; файлы больше 4 ГБ поддерживаются.
Чем это отличается от Audio Comparer?
Audio Comparer сравнивает треки целиком и ищет дубликаты песен. Audio Scanner ищет короткий фрагмент внутри длинных записей — другая задача, решённая тем же офлайн-подходом с акустическими отпечатками.
Системные требования
| Windows | 10 или 11 |
| Форматы | MP3, WAV, AIFF, FLAC, AAC/M4A, ALAC, OGG, Opus, WMA, APE, WavPack, MPC, TTA, AC3, DSD |
| Языки | русский, английский, немецкий, французский, испанский |